GPT-6.2 什么时候发布?在 ChatGPT 和 Codex 里哪里能用?
OpenAI 于 2026 年 11 月 17 日发布 GPT-6.2 Astra 和 GPT-6.2 Sol。如果今天要给团队选一个默认模型,我会先用 Sol 跑日常代码修改、数据汇总和有明确验收条件的任务。遇到互相矛盾的材料、要交给客户的复杂工作簿,或多次修改仍无法通过审查的代码,再用 Astra 复核。两款模型的标准 API 单价相差四倍,值得为之付费的是减少了哪一次返工。OpenAI 发布说明
发布时,Plus、Pro、Enterprise 和 Edu 用户可以在 ChatGPT Work 和 Codex 使用这两款模型。开发者通过 API 选择 gpt-6.2-sol 或 gpt-6.2-astra。在 Codex 中比较时,先记录模型名称、推理档位和可用工具。同一个请求,一个会话能读文件、另一个只能看到一张截图,结果很难归因到模型本身。OpenAI 可用范围 · API 更新记录
GPT-6.2 API 价格是多少?一次任务算给你看
下表是发布时标准短上下文的美元价格,单位为每百万 token。缓存读取这一列只适用于实际命中的输入。预算里还要单列付费工具、缓存写入等使用项目。OpenAI API 定价
| 模型 | 未缓存输入 | 缓存读取 | 计费输出 |
|---|---|---|---|
| GPT-6.2 Sol | $2.00 | $0.10 | $10.00 |
| GPT-6.2 Astra | $8.00 | $0.40 | $40.00 |
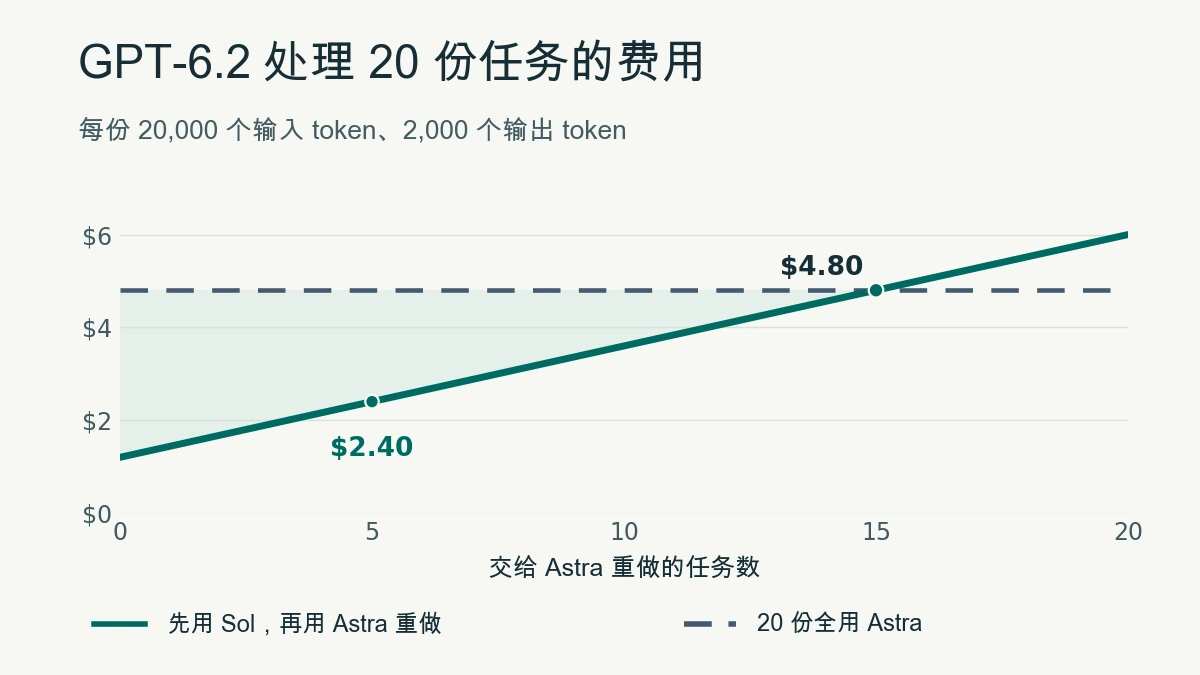
假设读一份材料用了 20,000 个未缓存输入 token,交回结果用了 2,000 个计费输出 token。按表计算,Sol 是 $0.06,Astra 是 $0.24。如果每天有 20 份这样的任务,全部交给 Astra 是 $4.80。先用 Sol 做完 20 份,再把其中 5 份按相同用量完整交给 Astra 重做,合计 $2.40。到第 15 份重做时,两种方案都是 $4.80。实际选择取决于哪 5 份需要重做,以及谁能识别它们。这是统一用量的预算示例,实账以每次请求回报的用量为准。
从上一代升级也要看具体型号。GPT-6.2 Sol 沿用 GPT-6.1 Sol 的标准费率。GPT-6.2 Astra 相比 GPT-6 Astra,未缓存输入与输出单价降低 20%,缓存读取从 $1.00 降到 $0.40。用旧 Astra 跑长任务的团队,可以先比较自己账单里三项用量各占多少。OpenAI 新旧模型价格说明
GPT-6.2 Sol 对比 GPT-6.1 Sol,编程和办公有什么变化?
在 OpenAI 的 GDPval v2 长程知识工作评测中,GPT-6.2 Sol 比 GPT-6.1 Sol 高 5.3 个百分点。同一评测里,GPT-6.2 Astra 比上一代 Astra 高 6.2 个百分点,使用的输出 token 少 22%。这个评测覆盖财务、设计等多步骤任务。对要做季度汇报的人,有意义的检验是给模型原表和团队模板,看同一处数字修正能否同时落在图表、页标题和说明文字里。OpenAI 的 GDPval v2 结果与工作簿示例
编程可以直接看 Cognition 的 FrontierCode 2.0。开源维护者为代码改动设定合并条件,榜单同时列出评分和按公开费率估算的平均单次运行成本。以下是 11 月 18 日可查的结果。Cognition 榜单与评分方法
| 模型与推理档位 | 运行环境 | 综合评分 | 平均每次运行 |
|---|---|---|---|
| GPT-6.1 Sol · max | Codex | 39.6% | $1.03 |
| GPT-6.2 Sol · max | Codex | 43.8% | $1.29 |
| GPT-6.2 Astra · max | Codex | 44.2% | $5.97 |
| Claude Fable 5.2 · xhigh | Claude Code | 50.2% | $17.73 |
两代 Sol 单价相同,在这组任务上的平均花费仍从 $1.03 变成了 $1.29。换到同代 Astra,综合评分又增加 0.4 个百分点,平均花费增加 $4.68。对于能跑回归测试、改动可以逐项审查的工作,这组数据支持先试 Sol。遇到一次代价很高的失败时,再看更强模型能否保住旧行为、补上会失败的测试,让维护者少改一轮。
GPT-6.2 Astra 和 Claude Fable 5.2,为什么单价一样,跑分成本却差很多?
两家的标准未缓存输入都是 $8,输出都是 $40,单位同为每百万 token。OpenAI 同时报告,在评估长程专业任务的 Agents’ Last Exam 上,Astra 的得分高出 Fable 5.2 5.5 分,测试成本约为对方的 5%。两个数字可以同时成立。价目表给出一个 token 多少钱,一项任务可以读不同数量的材料、调用不同次数的工具、生成不一样长的推理和回答。Anthropic 模型规格 · OpenAI 发布时的比较
这里还有一条容易漏掉的脚注。OpenAI 指明,Fable 5.2 的榜单结果排除了 9 项使用回退模型的任务。为自己的团队比较时,最好保留提前结束、回退和失败的记录,连同人工复核一起算进每份合格交付物的成本。这样,一份少引用了一张工作表、需要人手修半小时的漂亮报告也会反映在结果里。Agents’ Last Exam 排行榜与统计口径 · Onevium 的工作流成本核算法
用 630 笔销售记录判断,什么情况值得让 Astra 再看一次?
我们重新取得 Teacher’s Tech 教程里的两份原始工作簿,核对文件指纹,再逐行复算。一张有 630 笔销售,另一张有 200 位客户。给两个模型试同一道题时,可以只交原表和这一句请求,把下面的核对答案留给审核人。作者提供的教学数据 · Onevium 的分析脚本与旧文
老板想知道复购率,还想按渠道安排客户召回。请给他一段能直接读的结论,写清计算依据,以及现有数据还缺什么。
| 审核人核对什么 | 原表里能核实的结果 |
|---|---|
| 有多少客户被标记为复购 | 56 / 200 = 28%。这是原始标签。 |
| 有多少客户至少下过两单 | 157 / 200 = 78.5%。这个定义与原标签在 101 条记录上不同。 |
| 能否把每笔销售归给某位客户 | 销售表没有客户编号。只按渠道合并,630 行就会扩成 32,670 行,销售额从 74,428 被重复累计到 4,353,295。 |
表里的数字是本次复算所得,上文的模型跑分来自公开评测。模型如果交代了两种定义、指出缺少关联键,并建议先问清召回规则,这份答案已经可以拿去开会。模型如果只报 78.5%,接着给出一张精准到个人的召回名单,就值得升级复核。换了 Astra 仍然需要拿到客户编号和口径确认,才有依据落实到具体的人。把两次的答案、实际用量和你亲手修改的地方留在一起,才能决定下次遇到同类工作该选谁。
1M 上下文与工具调用,接入 GPT-6.2 前要核对什么?
两款模型都列出 1,050,000 token 上下文窗口,最大输入 922,000,最大输出 128,000。一次请求的输入超过 272,000 token,整次请求的输入与缓存费率变为短上下文的两倍,输出费率变为 1.5 倍。比如资料共 300,000 个未缓存输入 token,另有 2,000 个计费输出 token,按长上下文标准费率,Sol 是 $1.23,Astra 是 $4.92。Sol 模型规格 · Astra 模型规格
开发者可以走 Responses API 或 Chat Completions,调用工具要走 Responses API。在已有集成里迁移模型,可以用两个小请求分别确认文字返回和一次只读工具调用。使用 Onevium 的自定义服务时,也要对照上游模型标识和连接类型。最后再把完整工作交给已经通过这两个检查的连接。OpenAI API 更新记录 · Onevium 自定义模型连接